Datei lesen
295.481 Zeilen in einer flachen Datei, jede wiederholt ihr Restaurant und ihren Besuch.
Fallstudie · Ein Test mit öffentlichen Daten, kein Kunde
Bevor wir die Daten eines Kunden migrieren, proben wir mit Daten, die genauso unordentlich sind. Dies ist eine dieser Proben: die öffentliche Datei der Restaurantinspektionen von New York City, 295.481 Zeilen, in eine richtige Datenbank übertragen und Zeile für Zeile geprüft. Ein Test auf unseren eigenen Systemen im März 2026, kein Kundenprojekt.
01Das Problem
Die Stadt veröffentlicht jede Inspektion in einer einzigen flachen Datei. Jede Zeile wiederholt Restaurant und Besuch, sodass ein Restaurant immer wieder auftaucht; manche Zeilen enthalten gar keinen Verstoß, und manche Besuche sind auf den 1. Januar 1900 datiert. So sehen die meisten Geschäftsdaten aus, die wir migrieren sollen.
02Was wir getan haben
Wir haben die Datei in drei verknüpfte Tabellen aufgeteilt (Restaurants, Inspektionen und Verstöße), beiseitegelegt, was nicht stimmen konnte, und jede Tabelle gegen die Quelle geprüft, bevor wir fertig waren.
03Was es gezeigt hat
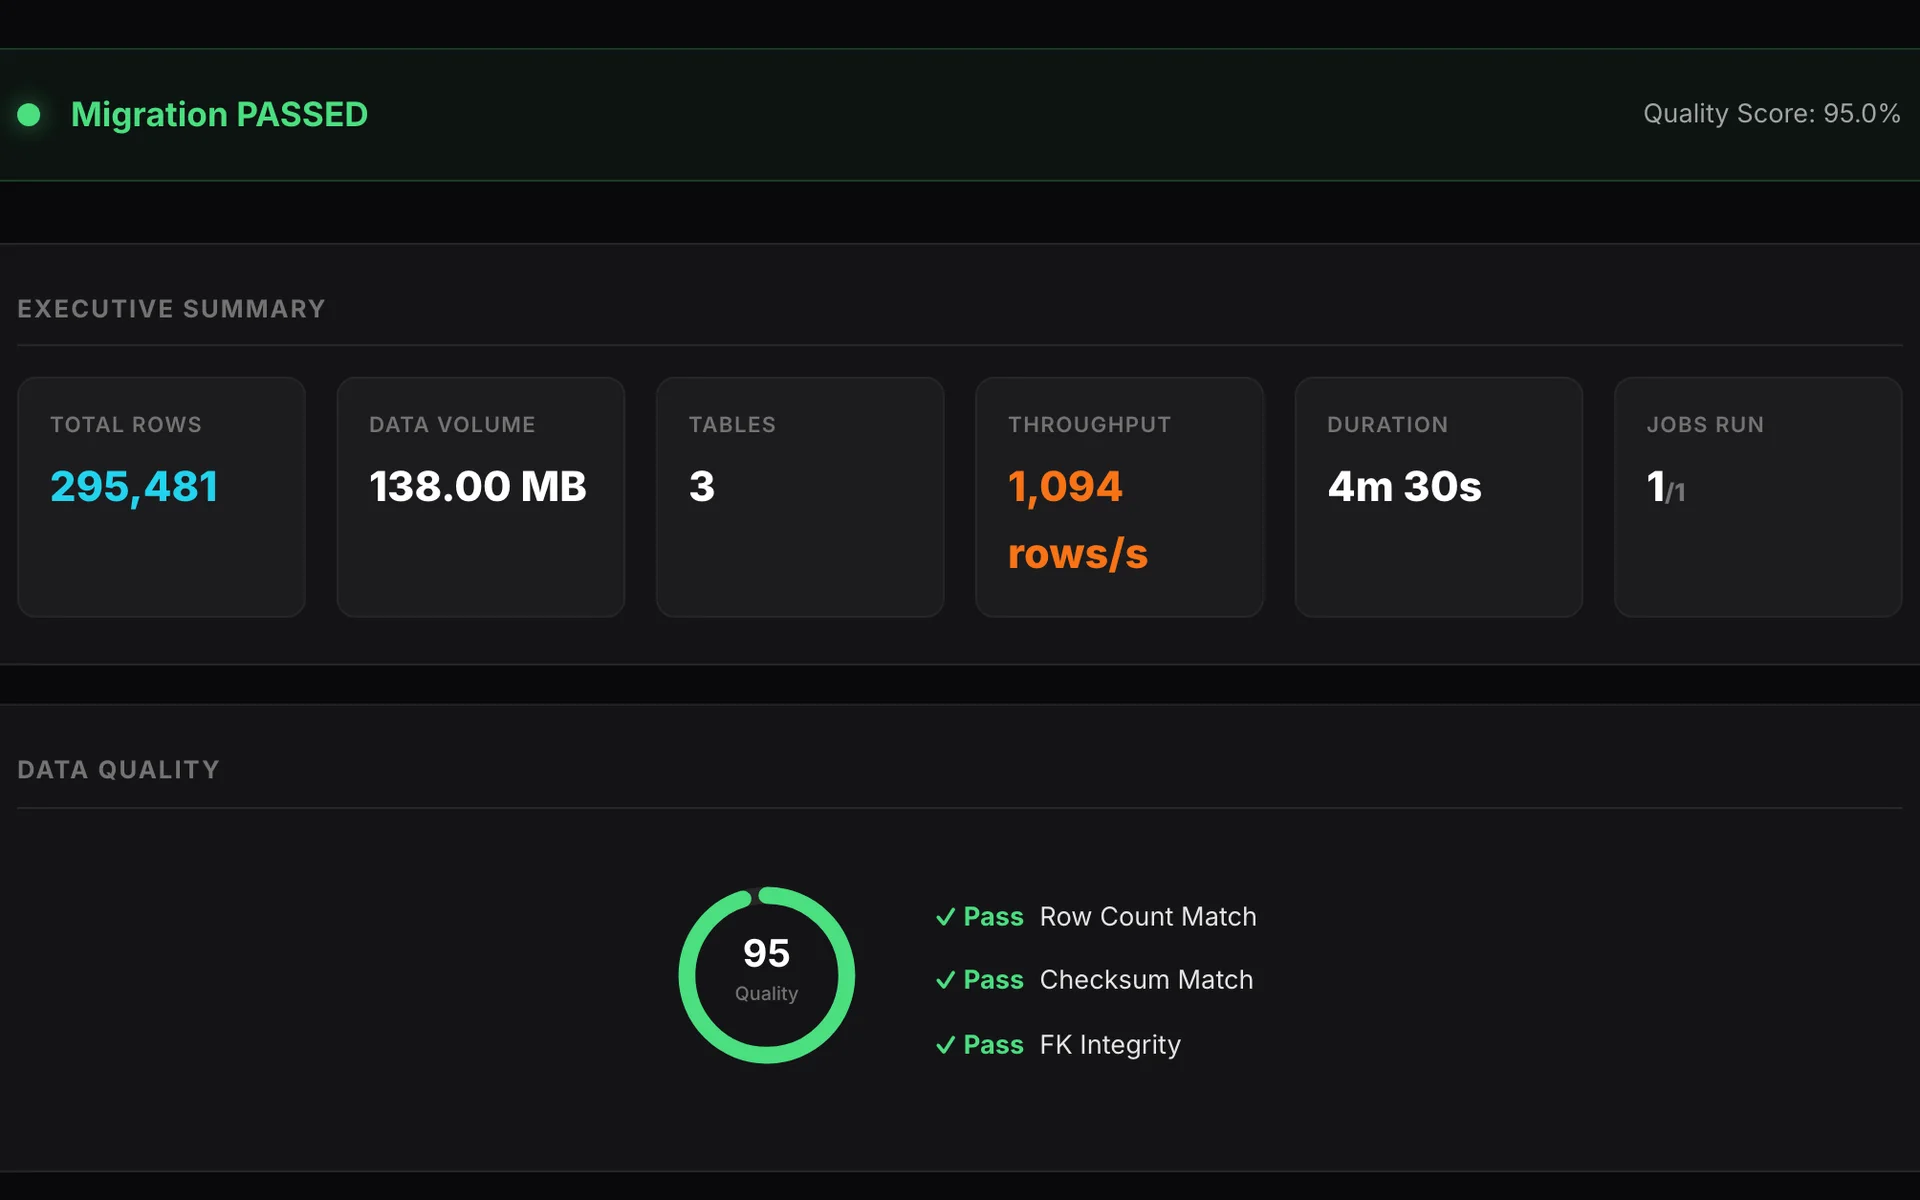
295.481 Zeilen wurden in 4 Min. 30 Sek. zu 3 verknüpften Tabellen, mit übereinstimmenden Zeilenzahlen und Prüfsummen und ohne verwaisten Datensatz. Die Probe fand außerdem fünf Fehler in unseren eigenen Werkzeugen, alle noch am selben Tag behoben.
Eine Datei rein, drei Tabellen raus
Die Datei schrieb jedes Restaurant und jeden Besuch bei jedem Verstoß erneut aus. Auf drei Tabellen verteilt, ist jedes Restaurant einmal gespeichert, jeder Besuch einmal, und jeder Verstoß mit dem Besuch verknüpft, bei dem er festgestellt wurde.
Wie der Lauf verlief
Diese drei Schritte laufen in jeder Migration, die wir durchführen; so ging jeder mit dieser Datei um.
295.481 Zeilen in einer flachen Datei, jede wiederholt ihr Restaurant und ihren Besuch.
Jedes Restaurant und jeder Besuch einmal gespeichert; unmögliche Daten und leere Zeilen beiseitegelegt und gezählt.
Zeilenzahlen, Prüfsummen und jede Verknüpfung zwischen Datensätzen gegen die Quelle geprüft.
Zeilen, die nicht stimmen konnten oder gar nichts enthielten, wurden beiseitegelegt und gezählt, nie geladen, als wären sie echt.
| Posten | Anzahl |
|---|---|
| Zeilen ohne Verstoß | 5.727 |
| Besuche vom 1. Januar 1900 | 3.425 |
Das Lesen der Datei ging schnell. Die meiste Zeit floss in den Aufbau der drei Tabellen und ihre Verknüpfung.
| Posten | Anzahl |
|---|---|
| Datei lesen | 90 Sek. |
| Drei Tabellen aufbauen | 180 Sek. |
1.094 Zeilen pro Sekunde, von Anfang bis Ende
Nach dem Umzug
Jede Quellzeile ist nachgewiesen: geladen, in ihr Restaurant oder ihren Besuch zusammengeführt oder beiseitegelegt und gezählt.
Die Prüfsummen von Quelle und Ziel stimmen überein.
Jede Inspektion hat ihr Restaurant, jeder Verstoß seine Inspektion.
Jeder geladene Wert wurde ohne Fehler in seinen Typ umgewandelt.
Der Lauf hat auch uns geprüft
Eine Probe soll Probleme finden, bevor die Daten eines Kunden betroffen sind. Diese fand fünf in unserer eigenen Pipeline; jedes wurde noch am selben Tag behoben und in die Checkliste aufgenommen, die wir vor jeder Migration durchgehen.
Nach jeder Migration läuft eine automatische Prüfung. Sie startete und brach dann ohne Meldung ab, wegen drei getrennter Einrichtungsfehler. Alle drei wurden behoben, und die Prüfung läuft jetzt durch.
Für einen Kunden: eine Migration ohne Prüfung dahinter, ohne dass es jemand merkt.
Sie suchte Informationen unter Namen, die sich inzwischen geändert hatten; ihre Ergebnisse wären also unvollständig gewesen. Jede Abfrage wurde gegen das System geprüft, wie es tatsächlich ist.
Für einen Kunden: ein Bericht, der etwas auslässt, ohne es zu sagen.
Die Prüfung einer abgeschlossenen Migration erneut auszuführen, speicherte schlechtere Werte und meldete vier Probleme, die es nicht gab. Sie erkennt jetzt eine bereits gemessene Aufgabe.
Für einen Kunden: Zeit, die mit der Suche nach nicht vorhandenen Problemen verloren geht.
Die Sicherheitsprüfungen vor einer Migration brauchten ein Werkzeug, das fehlte; sechs von zehn liefen daher nie, deshalb zeigt der Bericht 4 von 10. Sie wurden so neu gebaut, dass sie es nicht mehr brauchen.
Für einen Kunden: eine Migration mit weniger Schutz beginnen als versprochen.
Unsere Automatisierung sollte eine Adresse verwenden, die unsere Dokumentation nannte, die der Dienst aber nicht nutzte. Die Dokumentation wurde korrigiert.
Für einen Kunden: eine kleine Abweichung, die eine Migration in der Nacht aufhalten kann.
PostgreSQL zu PostgreSQL auf unserem eigenen Kubernetes-Cluster (16 vCPU, 32 GB), 28.–29. März 2026. Die Quelle wurde aus der öffentlichen CSV-Datei der Stadt geladen, mit einem Connector extrahiert und dann per SQL im Ziel dedupliziert, typisiert und über Fremdschlüssel verknüpft. Die Validierung verglich Zeilenzahlen und Prüfsummen mit der Quelle und prüfte beide Fremdschlüssel auf verwaiste Datensätze. Unsere Pipeline wurde seitdem neu gebaut; diese Seite berichtet den Lauf so, wie er gemessen wurde.
Wir proben sie zuerst an einer Kopie Ihrer Daten, und Sie geben frei, bevor etwas in Produktion geht.
Gespräch buchen