Fallstudie · TitanGrid
Wenn ein Rack heiß läuft, ist das Ticket schon eröffnet und der Techniker zugewiesen.
TitanGrid ist eine Betriebsplattform für Colocation-Rechenzentren: Überwachung, Techniker-Disposition, SLAs, Energieberichte und verbrauchsbasierte Abrechnung in einem System. Wir haben sie konzipiert und gebaut, und sie läuft unter titangrid.ai.
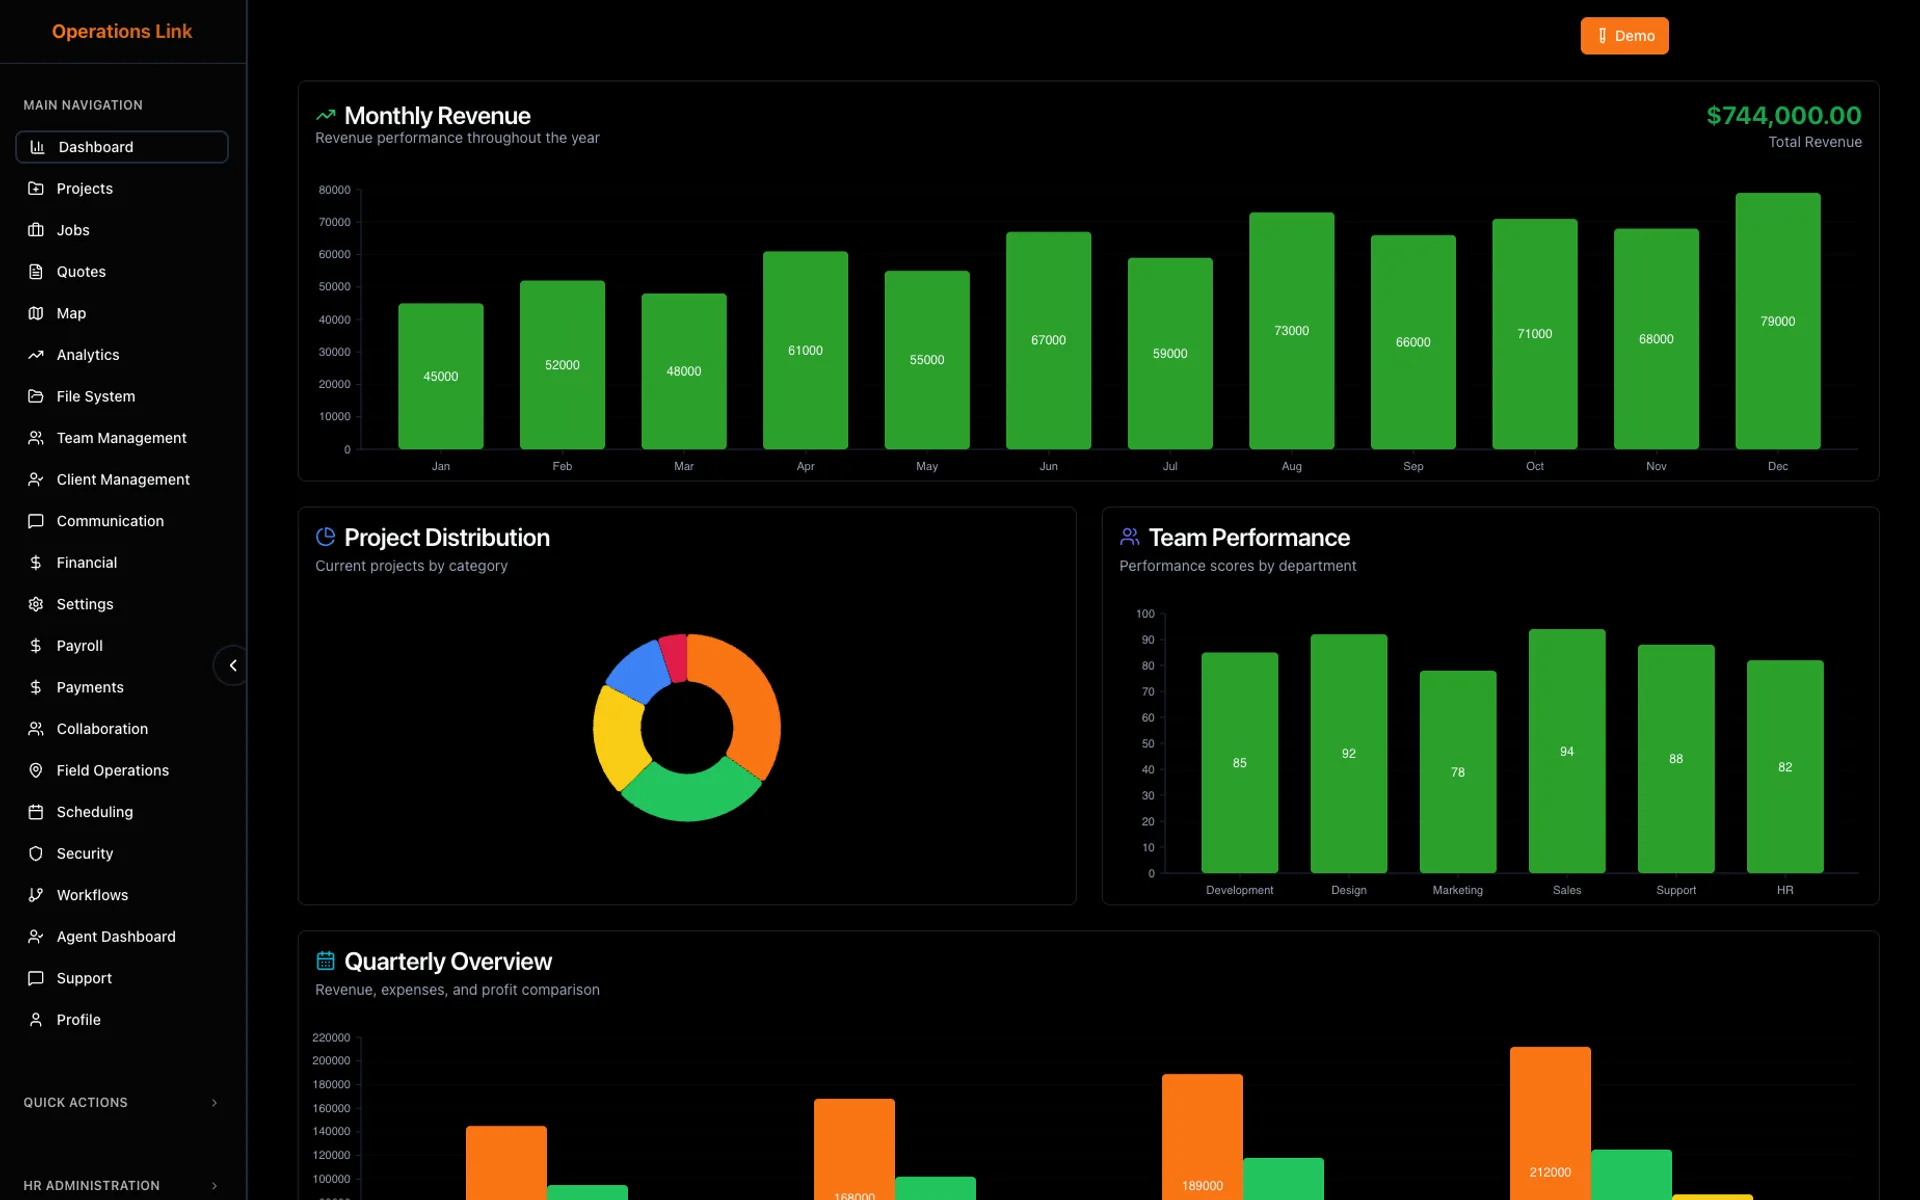
- Jedes Rack wird mit seinem eigenen Normalwert abgeglichen
- Jede Minute
- SLA-Eskalationsstufen, automatisch ausgelöst
- 50 · 80 · 100%
- Unter titangrid.ai
- Live
01Das Problem
Probleme fanden Menschen, die Diagramme beobachteten
Betreiber beobachteten Dashboards auf Probleme, wählten Techniker von Hand aus, verfolgten SLA-Fristen in Tabellen und lasen Zähler am Monatsende ab.
02Was wir gebaut haben
Ein System, das überwacht, disponiert und abrechnet
Ein Agent vor Ort liest die Geräte aus, die Plattform vergleicht jedes Rack mit seinem eigenen Normalwert, und Disposition, SLAs, Energieberichte und Abrechnung laufen alle auf denselben Messwerten.
03Was sich geändert hat
Die Reaktion beginnt, bevor jemand hinsieht
Ein Ausreißer eröffnet ein Ticket und einen Arbeitsauftrag und weist den am besten geeigneten Techniker zu, SLAs eskalieren von selbst, und der Stromverbrauch jedes Kunden wird stündlich gemessen.
Ein Tag im Rechenzentrum
Was früher jemanden brauchte, und was jetzt passiert
Ein illustrativer Tag, zusammengestellt ausschließlich aus dem, was die Plattform von selbst erledigt.
Über Nacht
Jetzt: Zustandswerte werden neu berechnet; ein starker Abfall erzeugt einen Ticketentwurf, ein vorhergesagter Ausfall den Entwurf eines Wartungsauftrags.
VorherProbleme werden entdeckt, wenn etwas ausfällt.
Der wöchentliche SLA-Bericht
Jetzt: Jeder Kunde erhält per E-Mail seine Verfügbarkeit und etwaige fällige Gutschriften, bereits berechnet.
VorherJede Woche ein von Hand erstellter Bericht.
Ein Rack läuft heiß
Jetzt: Innerhalb einer Minute existieren Ticket und Arbeitsauftrag, und der am besten geeignete Techniker ist zugewiesen.
VorherJemand bemerkt das Diagramm und sucht dann einen Techniker.
Ein Fehler, viele Alarme
Jetzt: Wiederholte Alarme desselben Geräts innerhalb von fünf Minuten werden zu einem Ticket zusammengefasst.
VorherDutzende Warnungen für einen Fehler.
Die SLA-Uhr läuft
Jetzt: Zur Halbzeit wird der Techniker informiert, bei 80% wird ein Incident eröffnet, bei 100% wird die Rufbereitschaft alarmiert.
VorherVerstöße werden erst im Nachhinein entdeckt.
Ein Besucher wird genehmigt
Jetzt: Zutrittsschein und Einladung werden versendet, und der Ausweis wird bei Ablauf automatisch gesperrt.
VorherAusweise werden zurückgegeben, oder auch nicht.
Vorher und nachher
Wer es früher gemacht hat, und was jetzt passiert
Jeder Teil des Rechenzentrumsbetriebs arbeitet mit denselben Messwerten. Wählen Sie einen Bereich, um zu sehen, was sich ändert.
Überwachung und Warnungen
Ein Agent vor Ort liest jedes Gerät aus, und die Plattform überwacht jedes Rack anhand seines eigenen Normalwerts.
| Die Aufgabe | Vorher | Jetzt |
|---|---|---|
| Probleme erkennen | Mitarbeiter beobachten Diagramme | Jedes Rack wird jede Minute mit seinem eigenen Normalwert verglichen; ein Ausreißer eröffnet ein Ticket |
| Alarmfluten | Dutzende Warnungen für einen Fehler | Wiederholungen eines Geräts innerhalb von fünf Minuten werden zu einem Ticket |
| Gemischte Geräte | Ein eigenes Tool für jede Geräteart | Ein Agent vor Ort liest SNMP, Modbus, BACnet und GPU-Telemetrie aus und behält die Messwerte, wenn die Verbindung abbricht |
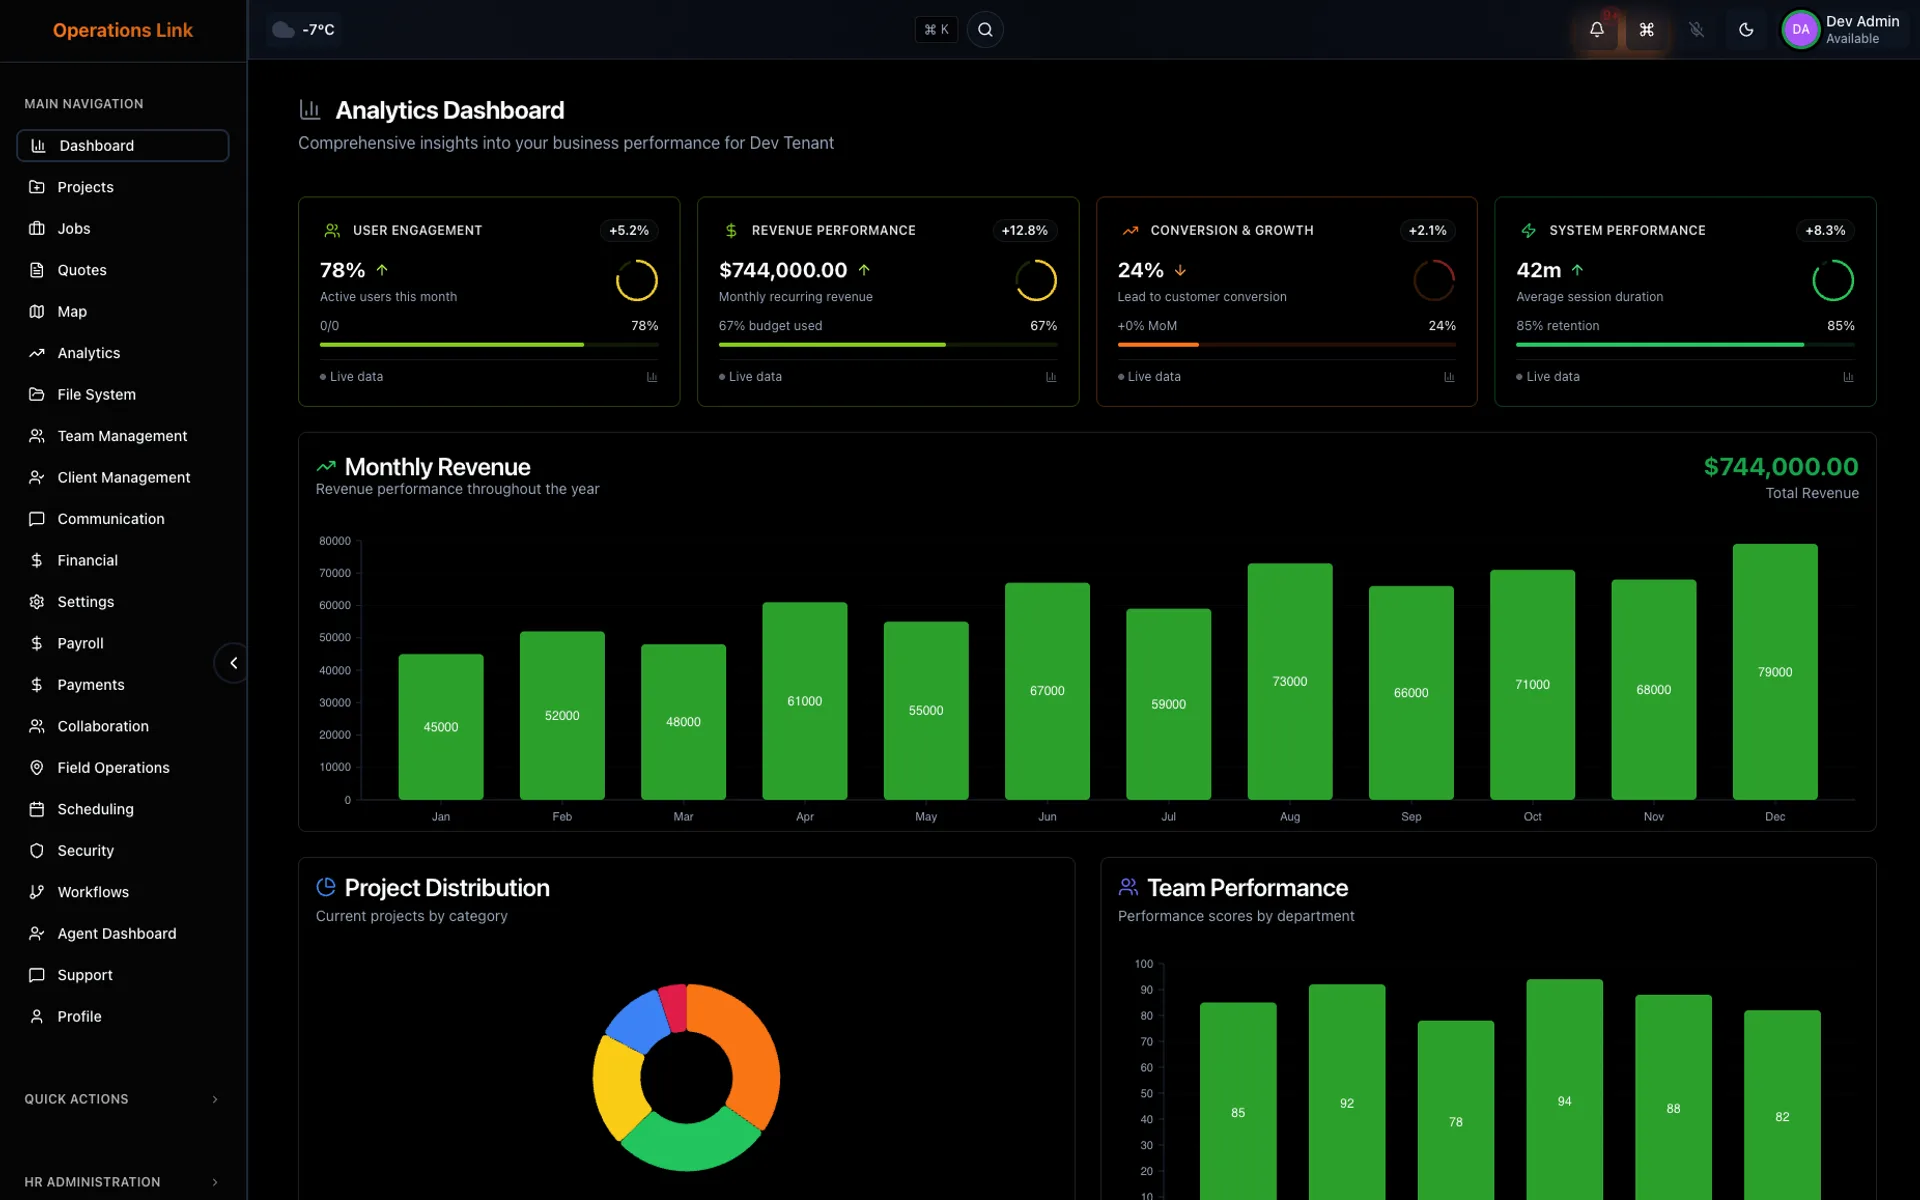
Ein heißes Rack
- Messwert außerhalb des NormalwertsErkannt
- Ticket und ArbeitsauftragEröffnet
- Am besten geeigneter TechnikerZugewiesen
Menschen behalten die Kontrolle
Jede Automatisierung lässt sich für jeden Kunden ein- oder ausschalten, und jeder Lauf hinterlässt einen Audit-Eintrag darüber, was er getan hat und warum.
Unter der Haube, für Ihr technisches TeamDetails anzeigen
Ein Agent vor Ort liest Telemetrie per SNMPv3, Modbus TCP und BACnet/IP sowie GPU-Telemetrie aus und sendet sie über MQTT; die Messwerte werden in einer Zeitreihendatenbank gespeichert. Die Plattform läuft auf Kubernetes mit Single Sign-on und schriftlich festgelegten Zugriffsrichtlinien.
Betreiben Sie Ihre Standorte mit Dashboards und Tabellen?
Wir bauen Überwachung, Disposition und Abrechnung rund um die tatsächlichen Abläufe an Ihren Standorten.
Gespräch buchen