Lire le fichier
295 481 lignes dans un seul fichier plat, chacune répétant son restaurant et sa visite.
Étude de cas · Un test sur des données publiques, pas un client
Avant de migrer les données d’un client, nous répétons sur des données aussi désordonnées que les siennes. Voici l’une de ces répétitions : le fichier public des inspections de restaurants de New York, 295 481 lignes, transféré dans une vraie base de données et vérifié ligne par ligne. Un test mené sur nos propres systèmes en mars 2026, pas un projet client.
01Le problème
La ville publie chaque inspection dans un seul fichier plat. Chaque ligne répète le restaurant et la visite, si bien qu’un même restaurant revient sans cesse ; certaines lignes ne mentionnent aucune infraction, et certaines visites sont datées du 1er janvier 1900. La plupart des données d’entreprise que l’on nous confie ressemblent à cela.
02Ce que nous avons fait
Nous avons réparti le fichier en trois tables reliées (restaurants, inspections et infractions), mis de côté ce qui ne pouvait pas être vrai, et vérifié chaque table par rapport à la source avant de conclure.
03Ce que cela a montré
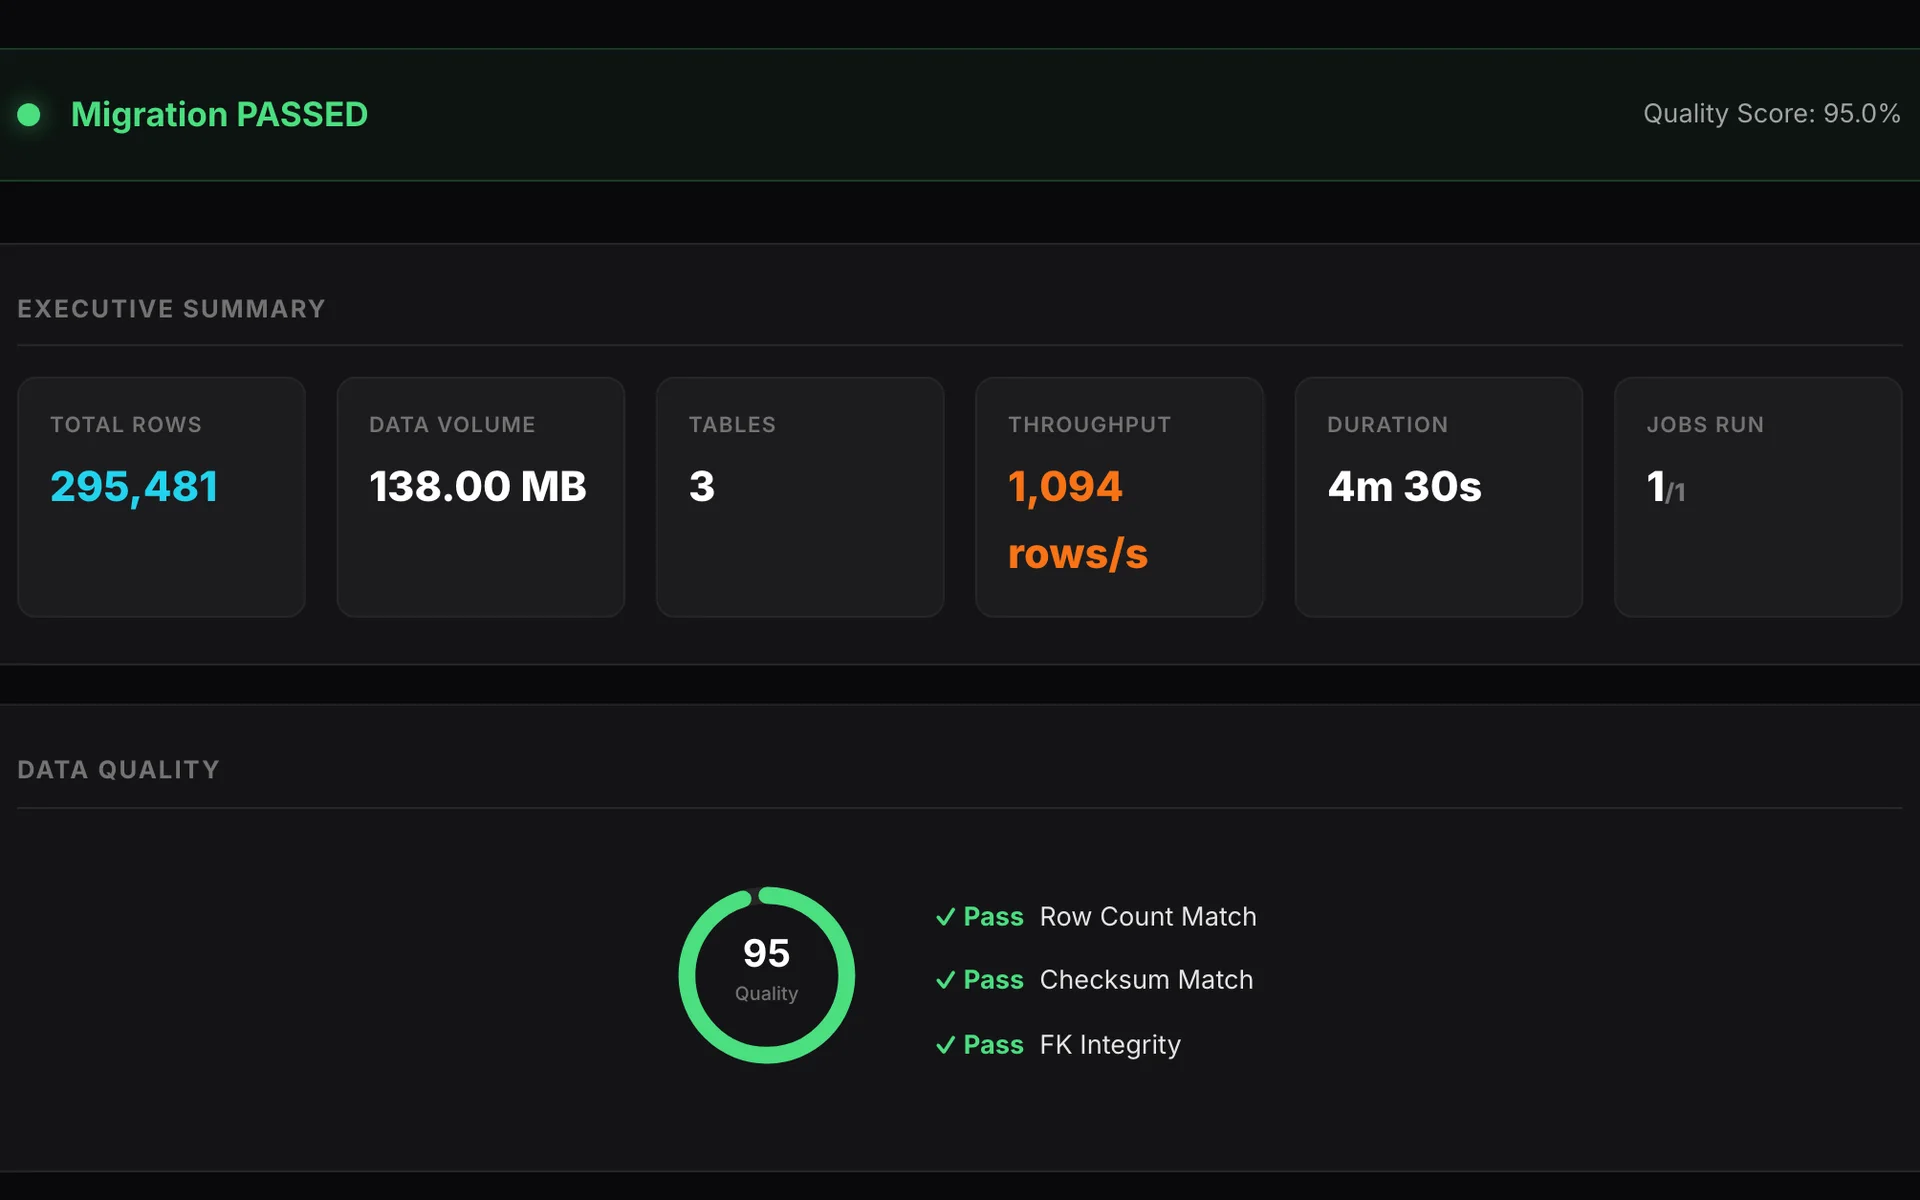
295 481 lignes sont devenues 3 tables reliées en 4 min 30 s, avec des nombres de lignes et des sommes de contrôle concordants et aucun enregistrement orphelin. La répétition a aussi révélé cinq défauts dans nos propres outils, tous corrigés le jour même.
Un fichier en entrée, trois tables en sortie
Le fichier réécrivait chaque restaurant et chaque visite sur chaque infraction. Réparti en trois tables, chaque restaurant est stocké une fois, chaque visite une fois, et chaque infraction est reliée à la visite où elle a été constatée.
Le déroulement
Ces trois mêmes étapes se déroulent dans chaque migration que nous menons ; voici ce que chacune a fait de ce fichier.
295 481 lignes dans un seul fichier plat, chacune répétant son restaurant et sa visite.
Chaque restaurant et chaque visite stockés une fois ; dates impossibles et lignes vides mises de côté et comptées.
Nombres de lignes, sommes de contrôle et chaque lien entre enregistrements vérifiés par rapport à la source.
Les lignes impossibles, ou qui ne contenaient rien, ont été mises de côté et comptées, jamais chargées comme si elles étaient réelles.
| Élément | Nombre |
|---|---|
| Lignes sans infraction | 5 727 |
| Visites datées du 1er janvier 1900 | 3 425 |
La lecture du fichier a été rapide. L’essentiel du temps a servi à construire les trois tables et à les relier.
| Élément | Nombre |
|---|---|
| Lecture du fichier | 90 s |
| Construction des trois tables | 180 s |
1 094 lignes par seconde, du début à la fin
Après le transfert
Chaque ligne source est justifiée : chargée, rattachée à son restaurant ou à sa visite, ou mise de côté et comptée.
Les sommes de contrôle calculées sur la source et sur la cible concordent.
Chaque inspection a son restaurant, et chaque infraction son inspection.
Chaque valeur chargée a été convertie dans son type sans erreur.
L’exécution nous a testés aussi
Une répétition sert à trouver les problèmes avant que les données d’un client ne soient concernées. Celle-ci en a trouvé cinq dans notre propre chaîne ; chacun a été corrigé le jour même et ajouté à la liste que nous vérifions avant chaque migration.
Une revue automatique s’exécute après chaque migration. Elle démarrait puis s’arrêtait sans un mot, à cause de trois défauts de configuration distincts. Les trois ont été corrigés et la revue va désormais jusqu’au bout.
Pour un client : une migration sans revue derrière elle, sans que personne ne le sache.
Elle cherchait des informations sous des noms qui avaient changé depuis ; ses conclusions auraient donc été incomplètes. Chaque recherche a été vérifiée par rapport au système réel.
Pour un client : un rapport qui omet des choses sans le dire.
Relancer la revue sur une migration terminée enregistrait de moins bons chiffres et signalait quatre problèmes inexistants. Elle reconnaît désormais une tâche déjà mesurée.
Pour un client : du temps perdu à chercher des problèmes qui n’existent pas.
Les contrôles de sécurité lancés avant une migration avaient besoin d’un outil absent ; six sur dix ne se sont donc jamais exécutés, d’où le 4 sur 10 du rapport. Ils ont été reconstruits pour ne plus en dépendre.
Pour un client : démarrer une migration avec moins de protection que promis.
Notre automatisation devait utiliser une adresse listée dans notre documentation mais que le service n’utilisait pas. La documentation a été corrigée.
Pour un client : un petit décalage qui peut bloquer une migration le soir même.
PostgreSQL vers PostgreSQL sur notre propre cluster Kubernetes (16 vCPU, 32 Go), les 28 et 29 mars 2026. La source a été chargée depuis le CSV public de la ville, extraite avec un connecteur, puis dédupliquée, typée et reliée par clés étrangères en SQL dans la cible. La validation a comparé les nombres de lignes et les sommes de contrôle avec la source et vérifié les deux clés étrangères pour les orphelins. Notre chaîne a été reconstruite depuis ; cette page rapporte l’exécution telle qu’elle a été mesurée.
Nous la répétons d’abord sur une copie de vos données, et vous validez avant que quoi que ce soit n’arrive en production.
Réserver un appel