Étude de cas · TitanGrid
Quand un rack surchauffe, le ticket et le technicien sont déjà sur le coup.
TitanGrid est une plateforme d’opérations pour les centres de données en colocation : surveillance, répartition des techniciens, SLA, reporting énergétique et facturation à l’usage dans un seul système. Nous l’avons conçue et construite, et elle tourne sur titangrid.ai.
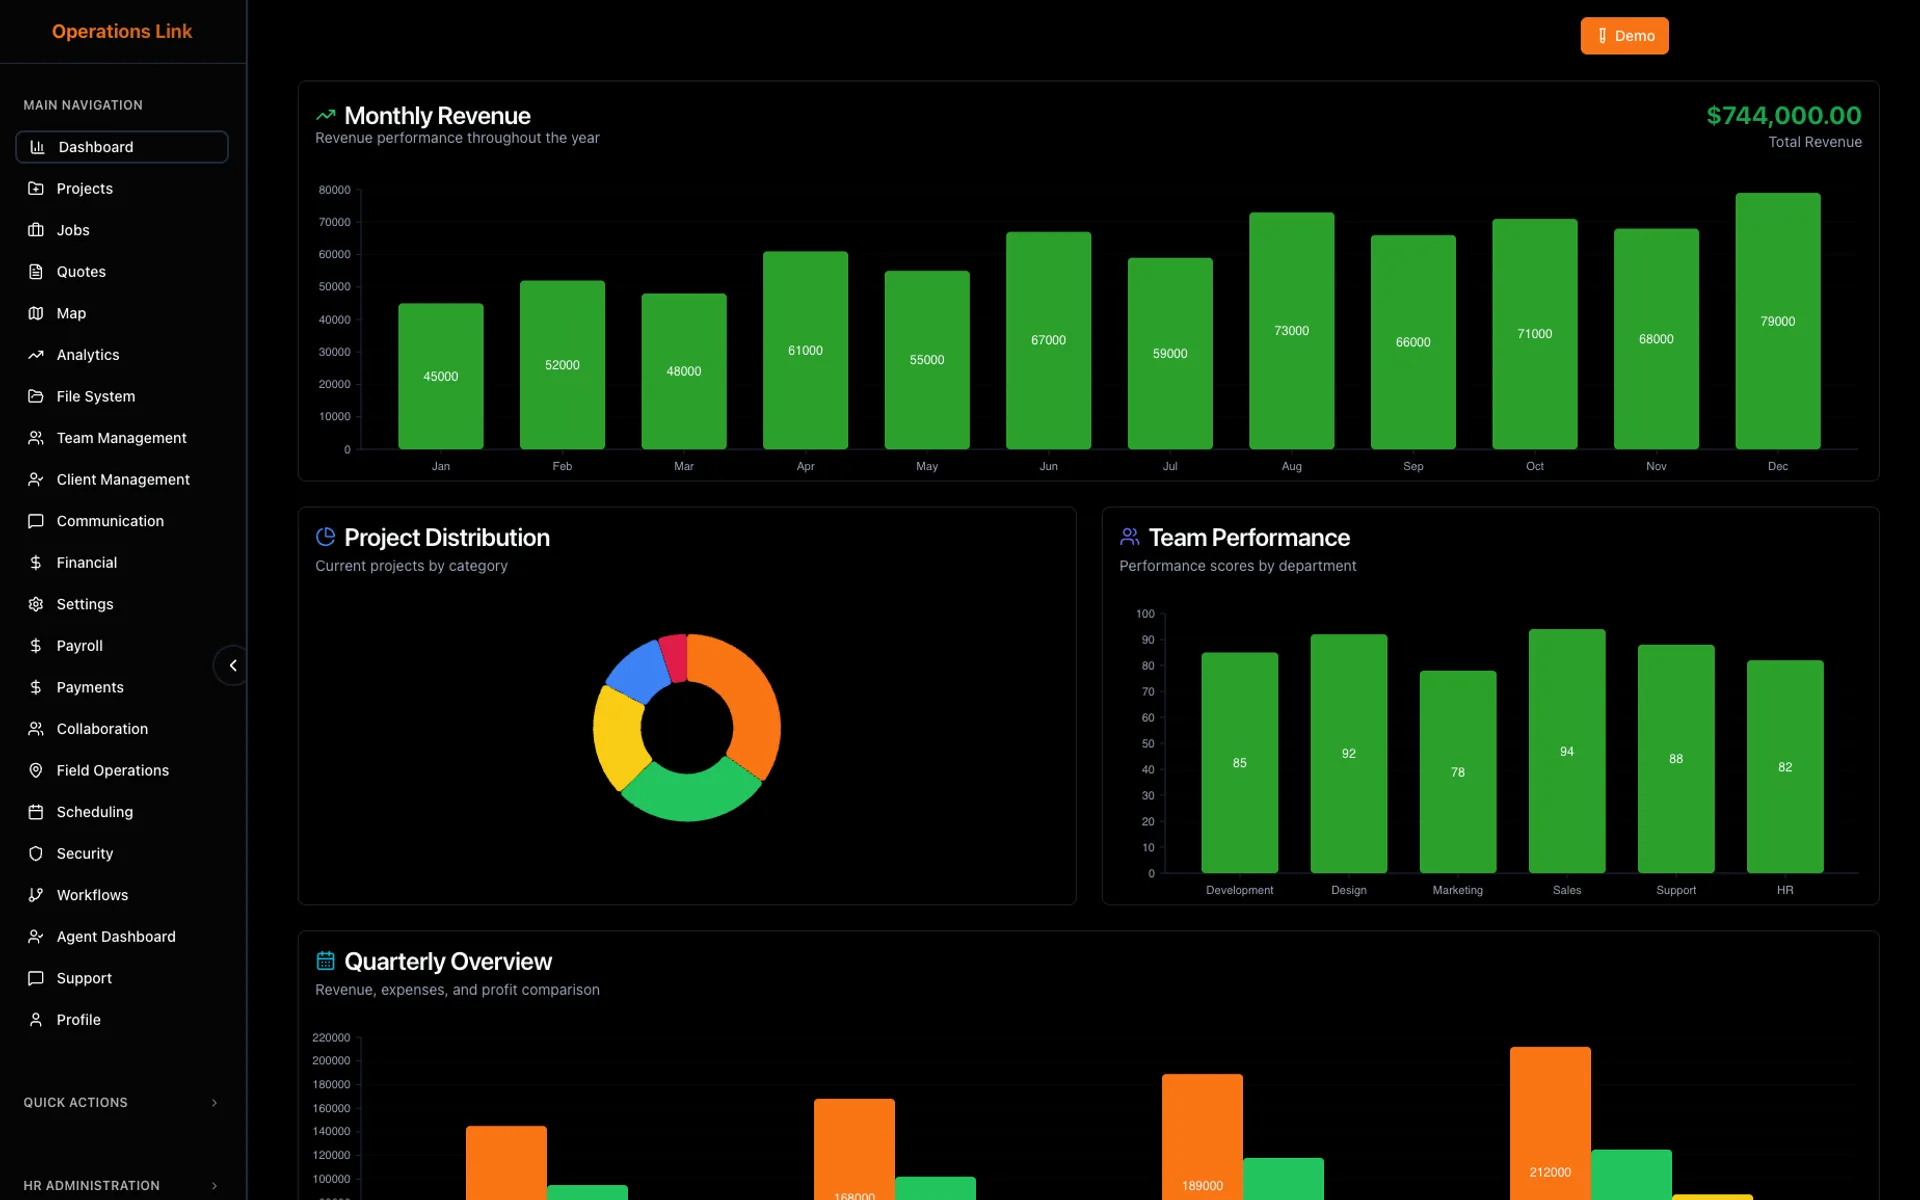
- Chaque rack comparé à sa propre normale
- Chaque minute
- Paliers d’escalade des SLA, déclenchés d’eux-mêmes
- 50 · 80 · 100%
- Sur titangrid.ai
- En ligne
01Le problème
Les problèmes étaient repérés par des gens qui surveillaient des graphiques
Les opérateurs surveillaient les tableaux de bord pour repérer les problèmes, choisissaient un technicien à la main, suivaient les échéances SLA dans des tableurs et relevaient les compteurs en fin de mois.
02Ce que nous avons construit
Un seul système qui surveille, répartit et facture
Un agent sur site lit les équipements, la plateforme compare chaque rack à sa propre normale, et la répartition, les SLA, le reporting énergétique et la facturation fonctionnent tous à partir des mêmes relevés.
03Ce qui a changé
La réponse commence avant que quiconque ne regarde
Une valeur anormale ouvre un ticket et un ordre de travail et affecte le technicien le plus adapté, les SLA s’escaladent d’eux-mêmes, et la consommation électrique de chaque client est mesurée heure par heure.
Une journée dans un centre de données
Ce qui demandait quelqu’un, et ce qui se passe maintenant
Une journée type, à titre d’illustration, composée uniquement de ce que la plateforme fait d’elle-même.
La nuit
Maintenant: Les scores de santé sont recalculés ; une chute brutale prépare un ticket et une panne prévue prépare un ordre de travail de maintenance.
AvantLes problèmes découverts au moment de la panne.
Le récapitulatif SLA hebdomadaire
Maintenant: Chaque client reçoit par e-mail son taux de disponibilité et les éventuels crédits dus, calculés.
AvantUn rapport construit à la main chaque semaine.
Un rack surchauffe
Maintenant: Dans la minute, un ticket et un ordre de travail existent et le technicien le plus adapté est affecté.
AvantQuelqu’un remarque le graphique, puis cherche un technicien.
Une panne, de nombreuses alarmes
Maintenant: Les alarmes répétées d’un même équipement en moins de cinq minutes sont regroupées en un seul ticket.
AvantDes dizaines d’alertes pour une seule panne.
L’horloge du SLA tourne
Maintenant: À la moitié du délai, le technicien est prévenu ; à 80 %, un incident est ouvert ; à 100 %, l’astreinte est appelée.
AvantLes manquements découverts après coup.
Un visiteur est approuvé
Maintenant: Le bon d’accès et l’invitation partent, et le badge se révoque de lui-même à son expiration.
AvantDes badges rendus, ou pas.
Avant et après
Qui s’en chargeait, et ce qui se passe maintenant
Tout ce qui fait tourner l’installation fonctionne à partir des mêmes relevés. Choisissez un domaine pour voir ce qui change.
Surveillance et alertes
Un agent sur site lit chaque équipement et la plateforme surveille chaque rack par rapport à sa propre normale.
| La tâche | Avant | Maintenant |
|---|---|---|
| Repérer les problèmes | Du personnel qui surveille des graphiques | Chaque rack comparé à sa propre normale chaque minute ; une valeur anormale ouvre un ticket |
| Avalanches d’alarmes | Des dizaines d’alertes pour une seule panne | Les répétitions d’un même équipement en moins de cinq minutes deviennent un seul ticket |
| Équipements hétérogènes | Un outil distinct pour chaque type d’équipement | Un seul agent sur site lit la télémétrie SNMP, Modbus, BACnet et GPU, et conserve les relevés si la liaison tombe |
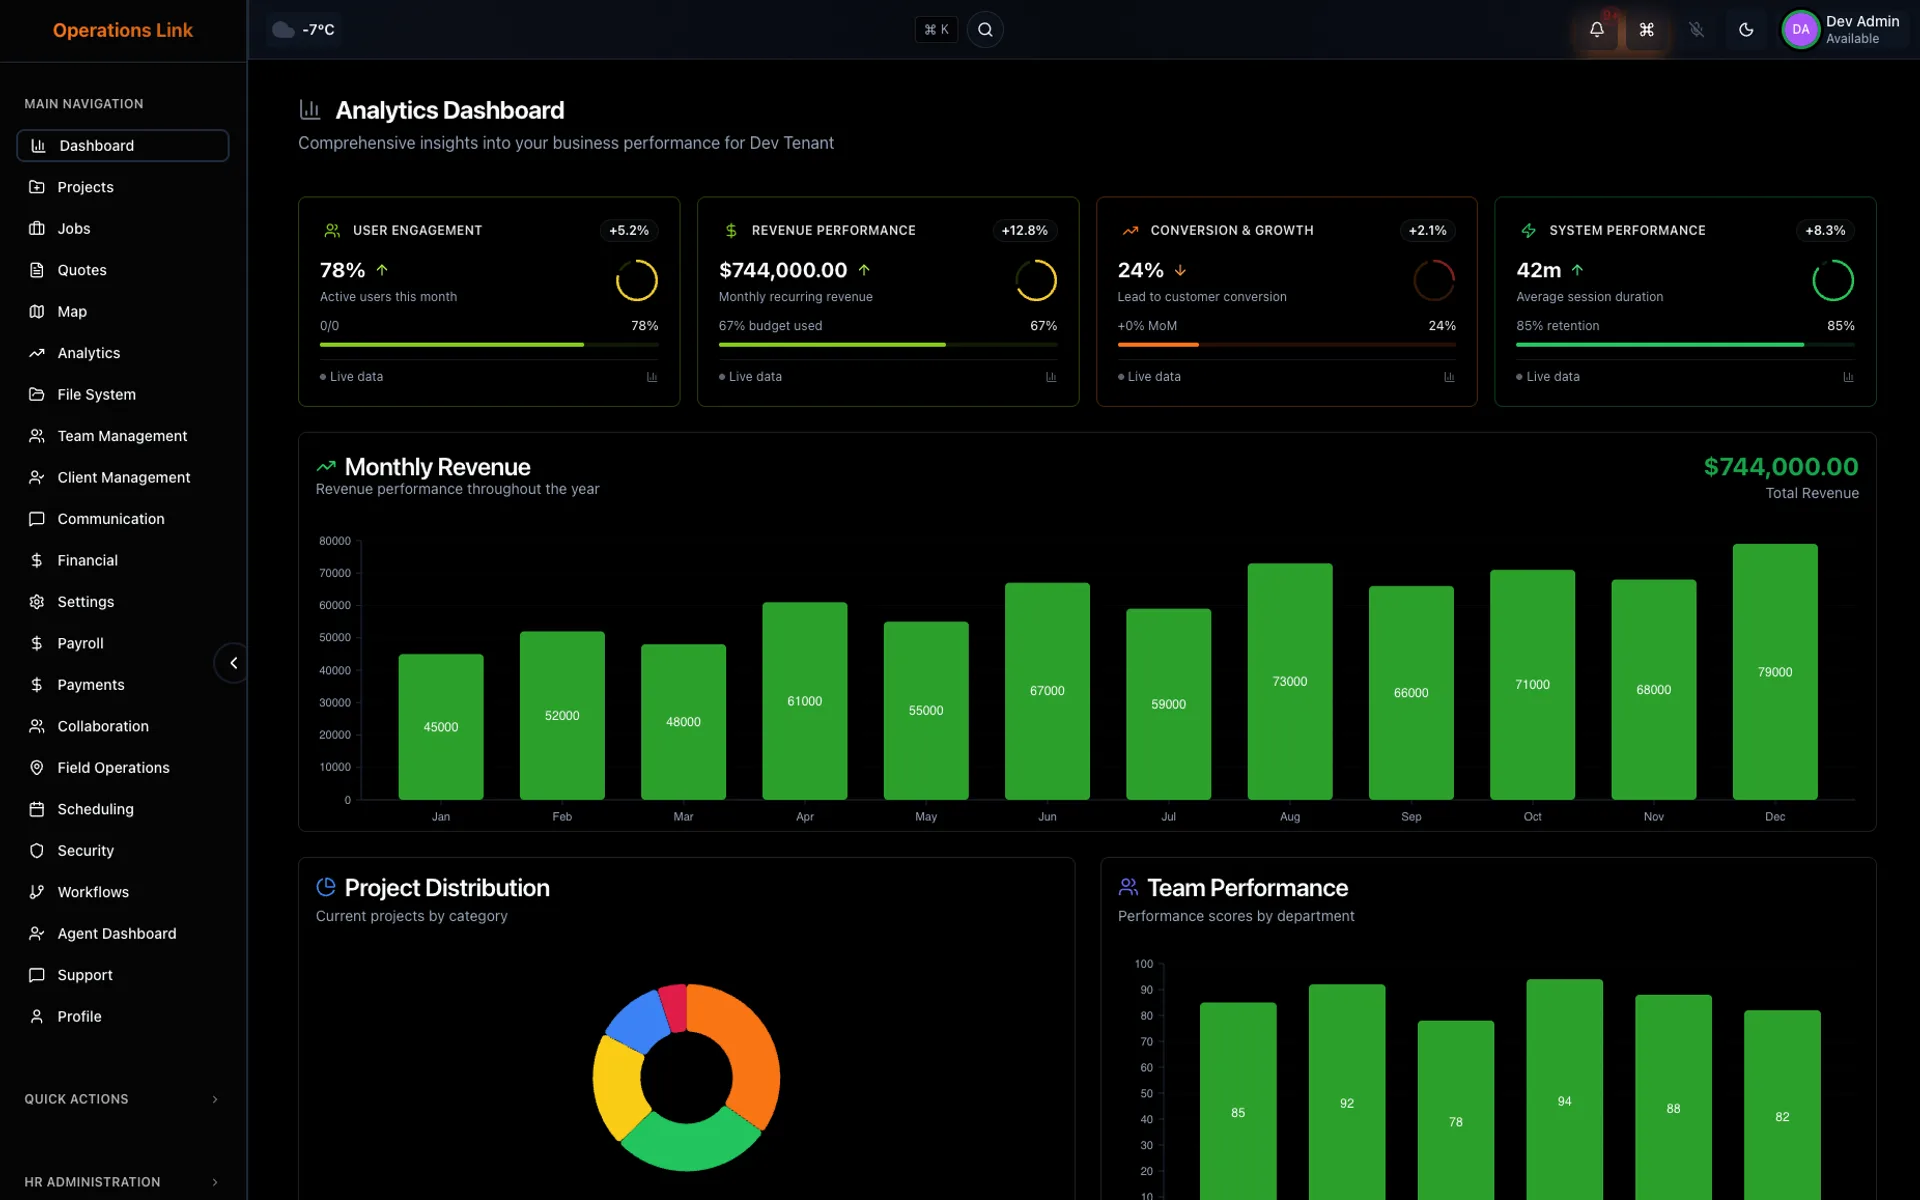
Un rack qui surchauffe
- Relevé hors de sa normaleDétecté
- Ticket et ordre de travailOuverts
- Technicien le plus adaptéAffecté
Les gens gardent la main
Chaque automatisation peut être activée ou désactivée pour chaque client, et chaque exécution laisse une trace d’audit de ce qu’elle a fait et pourquoi.
Sous le capot, pour votre équipe techniqueVoir le détail
Un agent sur site lit la télémétrie SNMPv3, Modbus TCP, BACnet/IP et GPU et l’envoie via MQTT ; les relevés sont conservés dans une base de données de séries temporelles. La plateforme tourne sur Kubernetes avec authentification unique et des politiques d’accès écrites.
Vous gérez vos installations avec des tableaux de bord et des tableurs ?
Nous construisons la surveillance, la répartition et la facturation autour du fonctionnement réel de vos sites.
Réserver un appel